
北京互联网法院建筑外景,2025年10月20日拍摄。摄影:N509FZ;来源:维基共享资源;许可:CC BY-SA 4.0。
2024年4月23日,北京互联网法院对殷某桢诉北京某智能科技公司等人格权纠纷案作出一审判决,案号(2023)京0491民初12142号。一名配音演员的录音被制成 AI 文本转语音产品对外销售,法院认定:AI 声音只要能被一般公众或一定范围内的公众识别出本人,就属于其声音权益的保护范围,判两家公司连带赔偿经济损失25万元。判决已生效,后被收入人民法院案例库。
从有声书录音到 AI 配音产品
据判决书查明的事实,殷某桢以配音、播音为职业。2019年,某(北京)文化传媒公司(下称文化公司)通过一家中介公司委托她录制两部有声作品,录制费为每小时90元,聘用协议约定录音作品的权利归文化公司。2019年5月10日,文化公司与某软件(中国)有限公司(下称软件公司)签订《数据授权使用协议》,把包括她所录《穿越之凰谋天下》在内的录音数据提供给软件公司;软件公司为这部约50小时的录音支付了20040.33元使用费。
软件公司只以这一部录音为素材,用人工智能技术开发出一款文本转语音产品,通过上海某网络科技公司运营的云服务平台对外销售。2022年1月28日,北京某智能科技公司(下称智能科技公司)与北京某科技发展公司签订在线服务买卖合同,由后者向软件公司下单采购,订单中包括这款产品。智能科技公司以应用程序接口(API)直接调用该产品,未作技术加工,就在自己运营的 AI 配音软件中上线为一款声音产品,平台页面显示播放量为3256728530次。
2023年5月,殷某桢发现网上多部配音作品使用了她的声音,经筛选和溯源找到智能科技公司的平台。法院于2023年6月12日立案,随后应原告申请追加另外四家公司为共同被告。原告请求下架相关产品、由智能科技公司和软件公司书面道歉、五被告连带赔偿经济损失50万元和精神损失10万元。法院于2023年12月12日、2024年4月23日两次公开开庭,并于2024年4月23日宣判。审理期间,两家公司称已在2024年2月下架相关产品,原告当庭认可。宣判后双方均未上诉,判决生效。
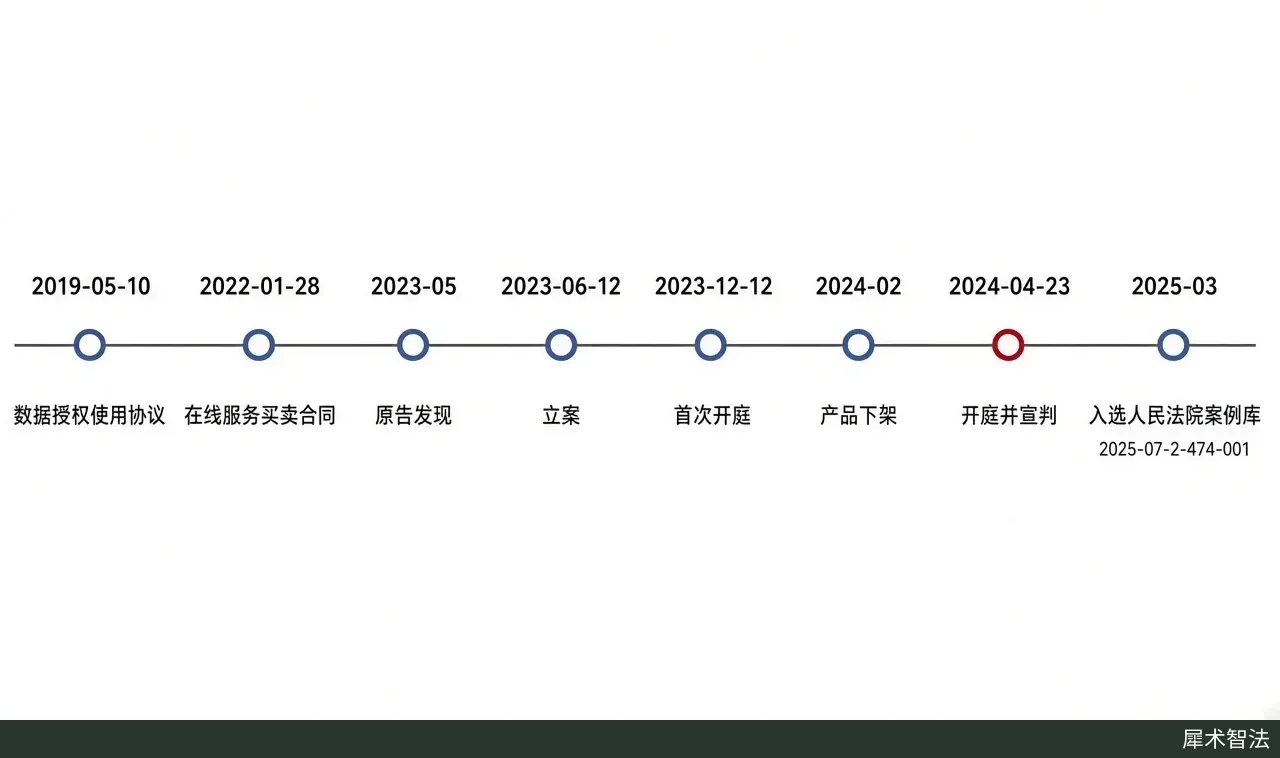
案件关键时间节点,依据(2023)京0491民初12142号判决书及人民法院案例库公开信息整理。AI 生成示意图。
AI 声音可识别性的认定
第一个争议焦点是:经 AI 处理后的声音,还算不算殷某桢的声音。法律依据是《民法典》第一千零二十三条第二款:“对自然人声音的保护,参照适用肖像权保护的有关规定。”第一千零一十八条把肖像界定为“特定自然人可以被识别的外部形象”,判决据此推论,声音与肖像一样,以具有可识别性作为受法律保护的前提。
法院的说明分两层。第一层针对一般声音:声音无形、不可视,识别性弱于肖像,通常要在反复或长期聆听的基础上才能认出特定的人;对配音等职业的人,只要一定范围内的听众能把声音与本人建立一一对应关系,即可认定具备识别性。第二层针对 AI 声音:关键在于是否仍能识别出特定自然人,只要一般社会公众或一定范围内的公众根据音色、语调和发音风格能够识别,该自然人的声音权益就“可及于该AI声音”。
被告方曾提出相反意见。软件公司主张可识别性应以一般社会公众知悉为准,AI 化的声音难以凭声音识别出原告;智能科技公司主张 AI 合成声音带有水印标记,切断了与自然人声音的联系。法院没有采纳这些抗辩,所依据的是两项具体事实:软件公司只用了原告一人的声音开发产品;法庭当庭用该产品进行文本转语音,生成的声音与原告的音色、语调、发音风格“具有高度一致性”。
北京互联网法院在宣判通稿中把这一标准概括为:可识别性的认定“应综合考虑行为人使用情况,并以相关领域普通听众能否识别作为判断标准”。案例入库时提炼的裁判要旨是:对于人工智能技术处理后的声音,一般社会公众或者一定范围内的公众根据音色、语调和发音风格能够识别出特定自然人的,该声音属于自然人声音权益的保护范围;未经许可使用,构成侵权。
授权链条与五被告的责任
第二个焦点是授权。法院区分了两类权利:文化公司依聘用协议对录音制品享有著作权等权利,也可在传播中使用原告姓名、肖像,但这不包括许可第三方对其声音进行人工智能处理。软件公司手里有一份《数据授权书》,内容是原告授予其不受限制、永久、全球、免许可费、不可撤销的许可,可用其语音创建合成或派生语音;但法院查明,这份授权书并非原告本人签署,而是由当初的中介公司代签,原告对此不知情,也不认可。
软件公司主张中介公司构成表见代理。由于授权书签署于《民法典》施行前,法院适用《民法总则》第一百七十一条,认为中介公司的代理关系在原聘用协议履行完毕后即已终止,软件公司也没有证据证明存在代签授权书的权利外观;同时,对声音进行 AI 处理可能对原告的人格和财产利益产生重大影响,软件公司却未合理审查代签方是否获得授权。表见代理因此不成立。
判决认定,五家被告都未经许可使用了原告声音,构成对其声音权益的侵害;但在责任承担上按过错加以区分:
| 被告 | 在链条中的角色 | 赔偿经济损失 | 书面道歉 |
|---|---|---|---|
| 文化公司 | 提供录音并对外许可 | 与软件公司连带赔偿25万元 | 原告未请求 |
| 软件公司 | 用录音开发并销售文本转语音产品 | 与文化公司连带赔偿25万元 | 判令道歉 |
| 北京某智能科技公司 | 采购产品并通过 API 上线到配音软件 | 无过错,不赔偿 | 判令道歉 |
| 上海某网络科技公司 | 运营销售该产品的云服务平台 | 无过错,不赔偿 | 原告未请求 |
| 北京某科技发展公司 | 经销商,代为下单采购 | 无过错,不赔偿 | 原告未请求 |
赔偿部分适用过错责任(《民法典》第一千一百六十五条)和共同侵权的连带责任(第一千一百六十八条)。智能科技公司不知道产品未获授权,以合理价格购买,未经加工直接调用,法院认为它对产品存在合法授权有“合理信赖”;经销商和云平台销售的产品有合法来源,也不存在过错。道歉方面,原告只要求智能科技公司和软件公司书面道歉,法院认为这一方式与侵权方式和影响范围相当,予以支持(第一千条)。停止侵权的请求因产品已下架,不再支持。
双方都没有就损失或获益举证,法院依第一千一百八十二条酌定25万元,考虑的因素包括:AI 声音仍体现原告的声音特征,在一定程度上能替代她的声音,使她丧失交易机会;声音带来的审美感受是此类产品市场价值的重要决定因素;软件公司只用原告声音开发产品,看重的是她在配音市场经过检验的音色、韵律和发音风格;以及产品播放量。被告称页面上的播放量是手动填写的预测数据,法院认为被告未能充分反证,且明知用户会把它当作真实数据仍予填写,因此采信该数据。精神损害赔偿因原告未证明受到严重精神损害,未获支持(第一千一百八十三条)。
另一个细节是和解协议。2023年9月25日,原告与文化公司签署和解协议,收到3.5万元补偿并约定撤诉;但原告此后未申请撤诉,文化公司和软件公司又提出新的和解方案,表示与原协议冲突时以新协议为准。法院认为双方都有推翻原协议的意思表示,该协议不能拘束本案裁判。案件受理费3300元由文化公司和软件公司负担。
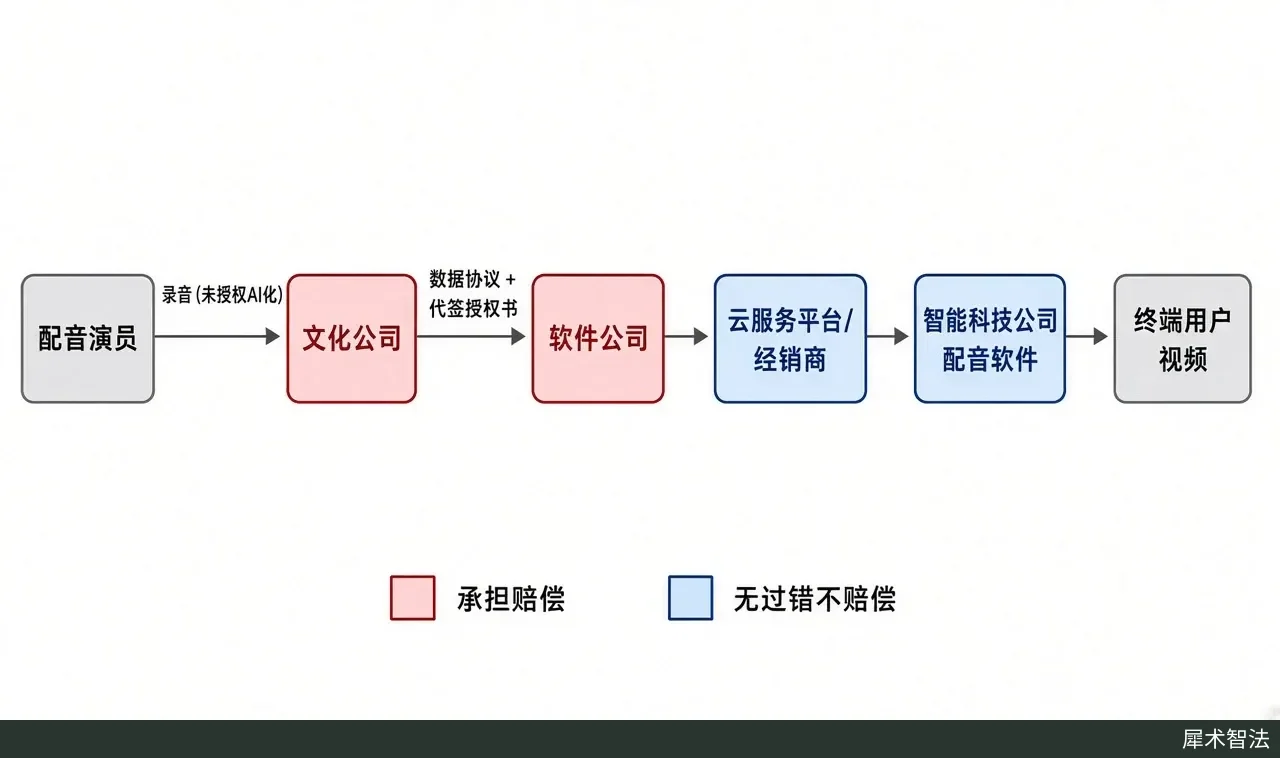
从配音演员录音到终端用户视频的授权与交易链条:红色为被判连带赔偿的被告,蓝色为被认定无过错、不承担赔偿的被告。依据判决书查明事实绘制,公司名称沿用判决书隐名称谓。AI 生成示意图。
对声音授权的启示与判决边界
宣判后,审判长、北京互联网法院副院长赵瑞罡表示,声音作为一种人格权益具有人身专属性,“对录音制品的授权并不意味着对声音AI化的授权,未经权利人许可,擅自使用或许可他人使用录音制品中的声音构成侵权”。北京互联网法院英文网站转载的《中国日报》报道还援引他的话,提醒企业在用 AI 处理或生成声音、图像时保持谨慎,并强调要取得当事人同意。
从判决说理中,可以归纳出三点与声音数据和语音产品直接相关的内容(以下为本文归纳,不是法律意见)。一是授权对象:录音制品上的著作权、邻接权与声音这项人格权益是两回事,拿到录音不等于拿到声音 AI 化的许可。二是授权来源:判决否定了代签授权书的效力,并以 AI 处理可能重大影响本人利益为由,要求开发方审查授权是否真正来自本人。三是下游位置:采购方、经销商和云平台因合理信赖免于赔偿,但同样被认定构成侵权,相关产品下架,采购方还被判书面道歉。
这份判决也有明确的边界。它是一审判决,因双方未上诉而生效,入选人民法院案例库后供类案参考。案件事实较为特殊:产品只用原告一人的录音开发,且当庭比对高度一致。对于混合多人声音训练、或未使用本人录音而只是风格相近的合成声音,判决没有直接回答,可识别性仍需按个案事实判断。25万元则是双方均未举证损失和获益时的酌定结果,不宜当作通用的赔偿标准。